2014年5月4日 星期日

從 IC流程中探索數位工程師的風格--III

在上述的 IC流程中,還有其他工程師也是參與其中;而你是數位工程師,你對其他工程師的責任是什麼你有清楚嗎?

案例分享:
在這個 IC流程中,數位工程師會需要類比工程師的幫忙部份,絕大部份是在synthesis LIB的參考和simulation時的模型建立。曾經遇過類比工程師需要數位工程師幫忙驗證他們建立的LIB是否正確?在這個IC流程中,確實可以幫類比工程師驗證LIB。但是當初在規劃行程時,有把這個時間算進去嗎?而且整個design在進入synthesis階段時,在很多的synthesis條件都沒有穩定的情況下,拿去幫類比工程師驗證 LIB是否是正確的選擇?所得到的結果是否會是正確?不正確的話,又需要多少時間收斂?所以類比工程師的LIB 驗證,應該是要在他自己的環境下去完成,而不應該在整合的環境中去做驗證。

IC流程裏,它不是幫類比工程師驗證LIB,它是依據類比工程師提供正確的LIB來做合成的工作。所以在synthesis之前,數位工程師就應要求類比工程師提供正確的LIB,不然就無法合出最合適的netlist。

為什麼synthesis時,要有正確的LIB?
DC-compiler依據LIB上的資訊,利用它的演算法,計算出哪一個gate是最合適的,計算出所有path的timing,告訴你哪一個是很緊的。依據這種概念,合出來的netlist才會是最接近真實的情況。

以下是案例的分享: 
類比工程師進度落後,告訴數位工程師,你用設delay方法來收斂 timing,類比工程師會按規格要求,處理好 interface timing,之後就可以tape-out。LIB部份,類比工程師會用手動的方式建立,讓整個 synthesis 流程順暢。 結果晶片回來後,在某些頻率下,會容易出錯。問題查了很多,原因是data出錯;所以數位工程師不可避免的成為主要的負責人。從design到synthesis,然後再到primetime check,之後還check floor-plan。結果發現,是類比工程師在設計介面時,使用推力不足的cell,所以在頻率快的情形下,setup-time violation。但這完全查不出來,因為LIB是非常完美的LIB,它不是擷取類比電路所計算出來的。它是人工的,所以在這個流程中,數位工程師當然查不到setup-time violation的報告。

合成時為什麼需要LIB?當然是想要在最接近真實的情況下,合出適合的netlist。因為LIB太過理想,所以合出來的netlist當然也是太過理想。

為什麼國外大廠的晶片穩定度高?技術好是一個原因。另外一個是他們嚴格要求IC流程的模擬要符合真實情況。所以他們一定用軟體來擷取類比電路,計算出正確timing後,才會公佈 LIB給數位工程師使用。儘量讓所有的數據都是最接近真實情況。

說完IC流程後。我大約分類一下風格,大家或許就可以知道我所說的是什麼意思。希望藉由這些分類,可以更了解你的工程師伙伴在想什麼?

1. Front-end RTL level數位工程師:遇到問題時,想盡辦法在RTL-level解決,並在RTL-simulation確保function的正確性。其寫出來的RTL code都是synthesizable,了解RTL code限制,也知道如何在DC環境下,寫出適合的constrain,也知道怎麼看懂的所有的timing report。其程式風格像前面RTL code的解決方式一.

2.Front-end post-level數位工程師:程式的風格像前面的RTL code的解決方式二,需要CAD的工程師幫忙保證 timing,無法在RTL-level就保證其timing和正確性。

3.Front-end artificial數位工程師,程式的風格像前面的 RTL code的 interrupt machine的原始範例,用人腦推論;對於DC-compiler提出來的 timing violation時,人工確認是否為假錯( false-error )。

4. cell-base數位工程師:使用verilog語法並參照standard cell/customized cell,畫出電路,不是用寫程式的觀念來寫程式的。

5. Back-end數位工程師: 熟悉DC的指令、primetime指令。對做ATPG, IO scan非常清楚,但是對RTL-coding觀念比較薄弱,因為對DC和 primetime指令熟悉,所以較適合做IP整合工作。

其實還有其他種類的數位工程師,在此就不一 一敘述,我就針對以後我的分享風格做一個說明,讓大家知道我為什麼這樣做,我的原因有在哪裏?我的要求在哪裏?

做為一個數位工程師,你會遇到的問題和困難一定會很多,有時候你無法保證一定可以在RTL level就把它解決,這其中包括 timing。 而 timing的部份,你可能需要別人的協助,才能把問題解決。但是我希望所有的問題盡量在RTL-level就解決完,除非不能解決時,才會請CAD幫忙保證 timing。之後如果我有分享程式時,你會看到我程式都會在RTL-level解決問題。每個程式也都一定會知道怎麼寫 timing constrain和看它的 timing report。 


2014年4月27日 星期日

從 IC流程中探索數位工程師的風格--II

就Back-end而言:
就Back-end的工作內容,主要的負責單位是CAD部們,數位工程師只是輔助的角色。如果是輔助的角色,那麼應該要注意哪些細節呢?

1. 建立primetime環境來驗證CAD做完APR後的netlist是否是符合自己的需求。

2. 請CAD給一套和他工作環境相同的primetime環境,做為最後驗證timing的path的依據。

3. 任何因為timing不符合時,需要修改netlist時,請CAD重做一份,數位工程師不代勞。

4.任何因為bug問題,需要修改netlist時,數位工程師要做,但是再請CAD工程依修改的netlist做出一份新的post netlist及timing model。不用數位工程師修改的版本來做primetime check。要用CAD的版本做primetime check。

5. 數位工程師要跑post-level simulation,驗證post-netlist是否是正確的?

6. 如果都驗證無誤時,要用CAD部門的版本當成是對外要tapeout的版本。

或許你會覺得有些地方是多餘的,像是第一點和第二點,就是要一套primetime來做timing check,誰建的還不都一樣。曾經遇到CAD拿到錯的timing constrain,結果CAD報一大堆timing violation,我用CAD的primetime環境查半天才發覺。所以當CAD報有timing無法收斂時,第一個要先確認是不是環境設定問題。畢竟你給出去netlist時,在DC都是timing收斂。很少有機會到primetime時,發散,除非 margin留得不夠,不然前後應該是一致的。所以為了確保CAD的環境的同步,就只好自己先建一個primetime,兩邊同步在相同的認知上,再開始工作。
另外,對於為什麼要堅持CAD部門提供tapeout的netlist?以及發現timing violation時,數位工程師為什麼不能自己修改?我舉一個案例分享。

有人曾經遇到,project leader發現bug和timing violation時,而為了趕上當初承諾的行程,project leader自己修正bug和timing後,自己用primetime check static timing以及formal check比對RTL和netlist。發現都沒有問題後,就直接tapeout。晶片回來後,發現有部份的設計,有hold-time violation的疑慮,project leader不敢說自己有修正netlist,直說是CAD的版本有問題,CAD部門查了半天,都查不出來。重做第二版時,就用新的RTL code合成,也真的是用CAD部門的netlist tapeout,結果第二版的晶片出現和第一版本的錯誤完全不同。總經理就疑惑,「不是沒有改RTL code為什麼會這樣子?」工程師在第一顆晶片查到的有些問題,都無法在第二顆晶片上得到解釋。Project leader也無法在第一顆和第二顆晶片實驗中,得到他完滿的解釋。最後是誰背黑鍋,還是CAD。因為hold-time violation沒有再出現,但是新的問題又出現,而從頭到尾第一顆晶片和第二顆晶片的RTL都是一樣的,只是第一顆的RTL是在tapeout前才底定。

Back-end這個階段,數位工程師只是輔助的角色,那就做好輔助的工作,一切都是CAD說了算,project leader也沒有能力去修正netlist,數位工程師的本份就是盡力幫CAD版本的netlist做最大的驗證;發現任何問題,就是要讓大家都知道,然後再跑一次流程。每個計劃中,有很多的成員加入,尊重每個領域的專業,並讓他確實的負責,這樣子才會讓加入的工程師有參與感和使命感,才能留住工程師的心。

token的轉移和劃分的概念,不光是用在design上,還可以用在IC的流程上,實際上,它很多其他的地方。整個project的規劃也可以用這個概念,只不過當方法和規則建立後,你願意嚴格遵守並確實的執行嗎?

有的數位工程師會嚴格遵守並確實執行,有的不會。我們都知道,事實上是很難,因為project leader有schedule(行程)壓力,project leader怕別人知道做錯的壓力等等,總是可以找到合理解釋,來縮減IC流程中的步驟。運氣好的話,沒事,運氣不好的呢?

工程師是做科學驗證的工作,希望能嚴格遵守並確實執行,提昇晶片的穩定度及品質。或許有著各式各樣的壓力,但是能堅持下去,就是知行合一實踐。不然光說不練,對於管理上也是一種很大的傷害。


2014年4月24日 星期四

程式中邏輯內涵的用意? ( 用If-else和case的舉例 )

程式中邏輯內涵的用意? ( 用If-else和case的舉例 )
程式應該要有邏輯的內涵,並非是表面所寫的面貌的。有邏輯內涵的程式可以讓程式便於看懂,對於後來接手的工程師而言,他可以藉由這些邏輯內涵和以前的工程師神交,瞭解前人的邏輯維思。

今天以if-else和case為例,來說明邏輯內涵是什麼?
我們都知道,if-else的寫法是和優先順序有相關的,而case是沒有優先順序關係的。但是,這是否是絕對的定律。我們來看一下下面的程式。
always@(*)
begin
    if(value==2’b00)
       A = 2’b00;
    else if(value==2’b01)
        A = 2’b01;
    else if(value==2’b10)
        A = 2’b10;
else
        A = 2’b11;
    end
end

以下是case的例子
case(value)
2’b00:   A= 2’b00;
2’b01:   A= 2’b01;
2’b10:   A= 2’b10;
default:  A= 2’b11;
endcase

在if-else的程式中,我們看到value=2’b00時的優先權最高,再來是value=2’b01 -> value=2’b10 -> value=2’b11。但我們想想value=00的最高優先權有意義嗎?value=00和value11會同時發生嗎?不會。那麼用下面的case來取代,是否是可行的?答案我想大家都是知道的。當一個數位工程師,我們要知道數位的內涵,而不是就表面的東西來解釋,然後就講一些沒有錯的道理來爭論。為什麼這麼說?就上面if-else的程式而言,這位工程師希望value=00的優先順序是最高的,然後依次是01 -> 10 -> 11,但是當每個值都不會同時發生時,那麼你排優先順序有什麼意義嗎?電路上的邏輯不會有任何錯誤,但是卻會造成你在合成電路時,電路實際上的latency以及gate count有所不同。

每個程式的寫法、意義,都是在代表你對事物的邏輯思考。而工程師本身必須對邏輯思考要精準到位,用你的程式來告訴別人你的思考邏輯是什麼?而不是只是結果是對的。因為當你的結果和別人一樣,但是推理過程和別人完全不同時,那麼在討論的過程中,如何培養默契?如何讓別人知道你的邏輯思緒是清晰?

因為邏輯只有0(錯)和1(對),當他的結果是對的,但內涵卻是不同時,你會怎麼做?舉例來說:如果有家長想抱孫子,而父母雙方有某種程度上不容易受孕,這時長家不管雙方父母,就是一定要抱孫子,此時,應該怎麼做?有人領養、有人做人工。但是如果有人是強抱別人家的小孩,你會怎麼想?當然會覺得是錯的。就算你是當事者的家長,應該也不會鼓勵這種行為。還是說,很好,有孫子抱就好,就算是犯法也不管。(PS: 或許例子舉得不是那麼好,希望能多多見諒 ! )

結果很重要,但是邏輯的內涵也同樣重要。因為這些都是代表邏輯思緒上的合理性。這種合理性是給後來的工程師去了解程式的一種方法。如果程式沒有合理性,就算結果是對的,對後來接手的工程師而言,無異是一場災難的開始。

一個全方位的數位工程師在寫程式時,不應只是考慮 latency和 gate count,你還要考慮它的邏輯內涵;讓別的工程師在看你的程式時,有前後一貫性,知道你的邏輯思維。當他看不懂你的程式碼時,他才能有所依據,按照你的邏輯思維來推演你的程式碼,慢慢地讀懂你的程式。
希望下次當你在寫 verilog 程式時,不是只是把它當成是電路來做,而是把它當成「程式」來看待,畢竟它的名稱還是叫做 verilog code,而不是叫做 verilog circuit。


2014年4月20日 星期日

從 IC流程中探索數位工程師的風格--I

今天想跟大家提一下IC 流程。因為我未來的分享也是和它有關。先溝通認知的部份,才能繼續下去。

我認為數位工程師的風格有很多,就像軟體工程師的風格也有很多種類。數位工程師的風格的分類,我是依據 IC流程來做分類的。每位數位工程師專精的地方有所不同,所以解決問題的思維也就不同。了解清楚 IC流程的權則劃分後,我會舉一些案例,讓大家去思考流程中的關鍵是什麼?初學者藉由這樣子的思索,探索想成為什麼樣子風格的數位工程師。


Fig: IC design flow
簡單說明一下流程。流程的開始是從規格的制定開始。確定規格後,開始規劃晶片的架構及功能。分配完工作後,就開始RTL coding。一邊coding一邊跑RT-level模擬。如果有錯誤,就回去修改RTL. 驗證所有的Design後,就去FPGA平台驗證,確認無誤後就可以合成netlist。Netlist和RTL做比對,確認兩者是相等的,就跑Gate-level 模擬。如果結果不是自己想要話,就是回到DC重新合成或是到修改RTL。都沒有錯,就給後段工程師APR. APR後,就跑Post-level 模擬。如果有錯,回到gate-level修正,或是RTL-level修正。如果都沒有錯,CAD工程師把後段的所有工作檢查完。然後就tape-out. 每個步驟都代表階段工作已驗證完畢後,才可以往下一個階段進行。

從Fig圖,我們看到,IC流程被分為front-end和back-end兩個階段。
先說Front-end: 
我相信每位數位工程師都知道front-end的工作內容,在此就不贅述。數位工程師是否知道front-end階段中,他應該注意哪些細節,才會產出高品質的netlist。我提出幾點來供大家參考,如果你還有更好的想法,歡迎你也提出來分享!

1.RTL code都要是synthesizable(可被合成的),而且知道自己每個constrain的條件以及interface的timing要符合60/40原則。(60/40原則: 留給別人60%的timing margin。自己只用40%, 也有人說是40-20-40比例,40%自己用,40%是別的工程師用, 最後20%是留給CAD工程師做APR使用。)

2. RTL-level simulation coverage 要到90%以上。

3. FPGA驗證到錯誤時,必須把這個錯誤的情況重新複製到RTL-level simulation,建立完整的驗證資料庫,下一位工程師在改程式時,就不用在FPGA驗證時,才發現舊問題。混淆FPGA工程師驗證的流程。

4.合成時,確認每個D-flip-flop都有timing report可讀;每個path都有timing constrain;interface的delay都很完整。Clock的宣告都是符合你的設計想法。

5.做好clock tree和reset tree的說明,讓CAD工程師了解你的設計想法。

6.確認給CAD工程師的tcl檔案是對的,而且和你的DC tcl檔案是相符合的。

7.確認合成出來的netlist是對的後,才交給CAD工程師。

以上七點,相信大家都是認同的,但是有嚴格要求做到嗎?


舉例來說。相信大家一定看過 Interrupt的機制。如果沒有看過也沒有關係,下面是常見的Interrupt的機制。

原始範例:
always@(posedge clki or negedge rstni)
begin
    if(~rstni)
        IRR00 <=0;
    else if(B==1) //error happend
        IRR00 <=1;
    else
        IRR00<=0;
end

assign IR_EN00 = IRR00 & (REG_IRR_EN[0]);
assign IR_RST00 = (clr_id==4'h0);

  always @(posedge IR_EN00 or negedge IR_RST00)
  if(~ IR_RST00)
      IRR_00_Z1    <= 0;
  else
      IRR_00_Z1    <= 1'b1;
  else
      IRR_00_Z1    <= IRR_00_Z1;


就IRR_00_Z1這個D-flip-flop而言,合成時,你有特別宣告IR_EN00為clock嗎?IR_RST00位於reset tree上,在做ATPG時,DRC不會過,DC-compiler會幫你修正,但是你怎麼知道它會幫你做?它做的修正是你想要的嗎?是對的嗎?
或許你想反駁,這些的 timing不是很重要,所以不用管。ATPG會幫你修正reset或是clock時,tool不會錯。這樣子的想法和上述哪幾點相衝突?
第一點 timing constrain不曉得要怎麼寫?
第四點 沒有每個D-flip-flop都有timing report,因為 clock無法宣告。
第七點 無法確認合成出來的所有 timing是對的,因為timing report無法全部產生。

如果程式改成下面的情況時,是不是就做到我們的要求?

解決方式一:
always@(posedge clki or negedge rstni)
begin
    if(~rstni)
        IRR00 <=0;
    else if(B==1 & REG_IRR_EN[0]) //error happend
        IRR00 <=1;
    else
        IRR00<=0;
end

always@(posedge clki or negedge rstni)
begin
    if(~rstni)
        IRR00_sync <=0;
    else if(IRR00==1) //error happend
        IRR00_sync <=~IRR00_sync;
    else
        IRR00_sync<=IRR00_sync;
end
     
always@(posedge nosleep_clki or negedge rstni)
begin
    if(~rstni)
    begin
        IRR_00_Z1_pre_sync1 <=0;
        IRR_00_Z1_pre_sync2 <=0;
    end
    else
    begin
        IRR_00_Z1_pre_sync1 <=IRR00_sync;
        IRR_00_Z1_pre_sync2 <=IRR_00_Z1_pre_sync1;
        IRR_00_Z1_pre_sync3 <=IRR_00_Z1_pre_sync2;
    end
end

assign IRR_00_Z1_pre_sync4 = IRR_00_Z1_pre_sync2 ^ IRR_00_Z1_pre_sync3;
     
always@(posedge nosleep_clki or negedge rstni)
begin
    if(~rstni)
    begin
        IRR_00_Z1 <= 0;
    end
    else if(IRR_00_Z1_pre_sync4)
    begin
        IRR_00_Z1 <= 1;
    end
    else if(clr_id==4'h0)
        IRR_00_Z1 <= 0;
    else
        IRR_00_Z1 <= IRR_00_Z1;
End

clki和 nosleep_clki是我們一定會宣告。跨clock domain設false-path。IRR_00_Z1的 timing是不是就可以報告出來。

那原來的那段程式,是不是就不要再用?當然不是,我們是要符合七點的要求,design沒有做錯,為什麼要放棄?只要做些修正,重新合成,還是可以用。

解決方式二:
module interrupt_machine (
input clki
,input rstni
,input B
,input [3:0] clr_id
,input scan_mode
,output IRR_00_Z1
)
reg IRR00;
wire IR_EN00;
wire IR_RST00;
reg IRR_00_Z1;
always@(posedge clki or negedge rstni)
begin
    if(~rstni)
        IRR00 <=0;
    else if(B==1) //error happend
        IRR00 <=1;
    else
        IRR00<=0;
end

assign IR_EN00 = IRR00 & (REG_IRR_EN[0]);
assign IR_RST00 =scan_mode?rstni : (clr_id==4'h0);

  always @(posedge IR_EN00 or negedge IR_RST00)
  if(~ IR_RST00)
      IRR_00_Z1    <= 0;
  else
      IRR_00_Z1    <= 1'b1;
  else
      IRR_00_Z1    <= IRR_00_Z1;
     
endmodule

將 Interrupt_machine單獨合成,請CAD工程師幫忙做成 Macro,確保 timing都是你想要的,以call macro方式來合成全部的電路;而 IR_RST00部份,你也修正到適合ATPG情況。當你在跑模擬或是 formal check時,都可以確保你的 reset沒有做錯。

這兩種做法都可以達到你的要求,但是它的差別是什麼你知道嗎?

第一種解決的情況是工程師自己可以解決,可以在RD團隊中解決問題。

第二種是需要CAD工程師幫忙保證你的 interrupt timing,這需要跨部門的合作。

這就是我所說的數位工程師的風格。你是要成為只相信tool的工程師;或是每個module都需要別人幫忙的工程師;亦或是自己可以處理每個bug,並想辦法驗證它的正確性以及 timing constrain的工程師。但是不管是哪一種,都希望你都能符合上述的七個要求。


2014年4月13日 星期日

producer and consumer concept ( II )

上一回,我們談到生產者與消費者的關係和資料前後一致性的特性。
在一個系統中,因為存取的動作複雜,產生許許多多不同的死結。因為有人試著把存取的動作規劃出優先順序,減少存取時會發生的死結。
在把優先順序說出來以前,我們要先把存取的動作歸納出基本的含意。然後才能把順序制定出來。
名詞解釋:
PMW: 這是一個posted write的動作。也就是說master 發出一筆 write data到slave。當送出這個動作後,master就不管是否真的會到slave。也就是說master在發出 write data後,就不負有任何的責任。
DRR:這是一個non-posed read的動作。也就是說master發出一筆 read data到slave。當送出這個動作後,master還是繼續等待slave的回覆。也就是說master在發出 read data後,還負對資料回來的責任。
DWR:這是一個non-posed write的動作。也就是說master發出一筆 write data到slave。當送出這個動作後,master還是繼續等待slave的回覆,確保資料是真的被寫到slave。也就是說master在發出 write data後,還負有對正確寫入的責任。
DRC: 這是一個回覆read的動作,也就是如果master有發出一筆 read data 到slave,那他就會等到slave回覆的DRC封包,得到它想要的資料及狀態。
DWC: 這是一個回覆 write 的動作,也就是如果master有發出一筆 write data 到slave,那他就會等到slave回覆的DWC封包,得到它想要的資料及狀態。
Posted: 指 master 送出去的命令後,即失去對它的責任。它有沒有正確到達目的地是別人的責任,不是 master的。
Non-posted:指 master 送出去的命令後,還負有對它的責任。它有沒有正確到達目的地是 master關心的事情。

Fig: system with complex devices.


PCI ordering rule. 
Tab: PCI ordering rule


Row是指隨後而來的的命令。而Col是指先前發出的命令。所以(Col, Row)則是指Col指令排在Row之前。所以我們來看看這個表格。

Rule1: 指(Col 2,Row 1),指一個PMW和PMW的順序,也就是說兩個相同的posted write指令,後面的posted write是否可以超前posted write。答案是不行。如果接受端對於收到資料是有順序性的,隨便違反順序是會讓系統出錯的。
Rule2: 指(Col 2,Row 2),指non-posted read是否可以超前posted write,答案是不行。如果這兩筆是指向相同的位址,那non-posted read超前posted write,不就讀到不正確的資料。
Rule3: 指(Col 2,Row 3),指non-posted write是否可以超posted write,答案是不行。就如同之前提過的生產者與消費者的模型。當生產者寫完資料後,還要把status清除為0。如果清除的動作超前寫入的動作時,此時消費者在讀status時,不就會誤認資料已經寫完,以致於讀到舊的資料。
Rule4: 指(Col 2,Row 4),non-posted read是否可以超前posted write,答案是不行。就如同rule3一樣,如果把讀status的動作超前生產者的寫入動作,那麼消費者就無法得到從系統中得到正確的訊息,以致消費者就會發生錯誤。
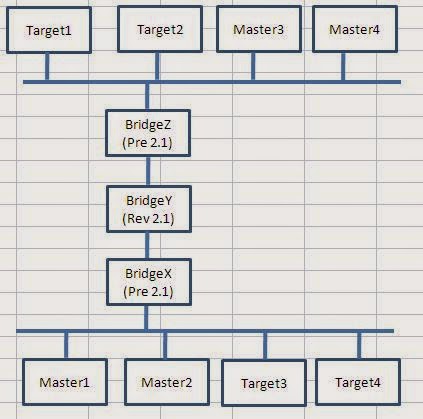
Rule5: 指(Col 3,Row 1)或是(Col 4, Row 1),指posted write是否可以超non-posted read或是non-posted write。答案是可以的。不超前的話,會有死結產生。請看Fig,如果master1  發出一筆non-posted read到bridge , master3送出一筆non-posted read到bridge,當這兩筆同時被bridge Y接受時,因為兩邊bus都被佔住,所以無法執行這兩筆non-posted。之後master1又發出一筆posted write時,這一筆要能超前non-posted read,不然整個匯流排就會被這兩筆non-posted read卡住,而無法執行。如果posted write可以超前non-posted read,則就有可能等到所有的命令均被執行後,non-posted read才能有機會得到被執行的機會。
Rule6: 指(Col 3,Row 4),指剛剛發出的read,目的端已經回覆回來,是否可以超前non-posted read或是non-posted write。答案是可以的,因為既然正確的答案已經回傳回來,當然是要讓它儘快回到發送端,以便讓發送端再送出下一筆的命令。
Rule7: 指(Col 5,Row 1),是指posted write是否可以超前回覆的命令,答案是可以的。以生產者-消費者模型為例,如果data buffer和flag, status是不在相同的bus上,consumer發出一筆讀取status和flag的命令出來,在得到正確的訊息後,producer正要把資料寫入data buffer,所以這兩筆的資料都是正確的,沒有順序相依關係。所以超前是不會讓系統造成錯誤發生。
Others:其他的格子裏是寫Yes/No,是指超前可以,不超前也可以,要自己判斷。也就是說,如果命令間是沒有相關性的,那你就超前,如果有相關的,那你就不可以超前。這牽涉到系統規劃,以及和軟體間的溝通,所以沒有特別的答案,一切看自己。

其實,在這7個規則裏,都是因為存取動作的順序會造成資料的錯誤或是死結產生,所以才會特別告訴工程師,在遇到這些情況時,是可以超前,或是不可以超前。我沒有把會造成死結的情況詳細說明,這是因為,從Fig圖中,我們已經知道Bridge有三個,其中兩個是支援2.1版前的,另一個是支援2.1版的。因為版本的不同,造成命令在處理中,會有死結產生。
要詳細知道死結產生的情況,是要對 PCI 的規格了解。我怕有些人是不知道,所以用另一種方式來解答,是從命令上的意義來解答。如果想知道更周全的,建議詳讀 PCI 規格,就可以讓你能更了解為什麼要制定這些規則。


2014年4月6日 星期日

producer and consumer concept ( I )

今天我想討論一個觀念,producer(生產者) and consumer(消費者) ordering model。我覺得這是一個做為一個系統整合的數位工程師應該要具備的基本觀念。但是,這個觀念是來自於 PCI 規格書裏。相信很多人都沒有看過 PCI 的規格,我怕我在解釋這個觀念時,有人會因此而看不懂。但如果省略,又怕很多工程師在做系統整合時,常犯一些讀寫設計的問題。實在很兩難 !
掙扎許多,還是決定試著解釋看看,希望有人可以看懂,如果有不懂的,可以留言給我,或是寫信來討論。
做為一個數位設計工程師,必須有一個觀念,那就是在數位訊號處理過程中,訊號不會無中生有。必須要有人給你訊號,然後你才能做事。而這時,就會有生產者的角色產生。有了生產者,當然就必須要有消費者來消費。在這生產-消費的過程中,產生了讀寫動作,造成許許多多讀寫順序的問題。也讓我們知道「資料前後一致性(consistent view of data)」的觀念在系統中扮演的角色是有多重要了。

在生產者與消費者的模型裏我們要探討的是: 
1. 生產者與消費者的順序觀念(the ordering of producer and consumer)
2. 資料的前後一致性的觀念( the consistent view of data)

Fig1: producer and consumer


假設,有一個生產者,一個消費者。生產者想把生產出來的資料存入data buffer中,它必須先確定是否data buffer沒有正在被讀,或是完全沒有被讀過?當生產者在寫入時,flag會被設定為1,而當寫完時,status會被清除為0。當消費者要讀出來時,必須先確定是否data buffer沒有正在被寫或是完全沒有被寫過。當消費者在讀出時,flag會被消除為0,而當讀完時,status會被設定為1。經由這些動作,我們可以確保資料不會被覆寫,也不會被覆讀。flag和status的做法的概念是很好的基礎觀念,值得我們拿來借鏡,應用在設計資料存取的一致性,尤其是設計hardware和firmware在對同一塊資料存取時,是一個很好用的方法。

如Fig1所示,當生產者和消費者都是在同一個bus(匯流排)時,讀寫動作是簡單,不會有任何的問題。但是如果生產者和消費者是如Fig2所示,讀寫動作就不再是單純的。這時就產生了優先順序的問題,不然就會有死結(dead lock)的情況產生。
Fig2: complex producer and consumer


如果生產者已經讀過 flag 和 status,想確定目前data內的資料是否是舊的,所以發出一筆讀status命令給Bridge。同時,消費者正在讀資料回來,所以發出一筆讀data的命令給Bridge。Bridge同時接受兩個不相同方向的命令,放入buffer中,接著對收入的命令的目地端的匯流排發出要求,來完成所被托付的任務。但是此時,生產者佔住了它自已的bus,而消費者也佔了它自己的bus,而在Bridge兩端的命令都無法被執行,因為它沒有拿到使用bus的權限。此時,生產者無法完成它的動作,因為消費端的bus它無法取得使用權,所以命令被卡在Bridge,下不去。消費者也無法得到它想要的data,因為它的命令也同樣是被卡在生產端的bus,無法執行。這時該怎麼辦?或許你會想,那就做一個timer,如果等 timeout,就重新執行。就可以解決死結的問題。這樣子的方式,確實可以解決死結。但是,如果每次都需要重新開始,每次開始的時間點都是一樣的,那麼是不是每次都會遇到死結的情形都會發生。這時,我們就遇到另外一個問題-飢餓狀態(starvation),這又是另一個問題的產生。

亦或者你會想要把兩邊的 timer 設成不一樣長,這樣子是不是就有機會可以解?是的,但是這樣子的做法有效率嗎?遇到死結->等 timeout ->遇到死結 -> 等 timeout ->終於沒有死結。這種把問題丟給「機率」解決,似乎不是很好的辦法。如果我們把每個命令制定優先順序,我們就可以試著找到一種順序來解決所有的死結問題。
所以,制定一個「命令的優先順序」就變得很重要。但優先順序要怎麼制定?才可以保有效率,也可以保持資料前後一致性的特性,不會造成資料存取的錯誤。這又是另一個大篇長論,請容我賣個關子,待下回分解 !

2014年4月3日 星期四

是否long pulse 訊號一定要拿來做同步處理?

是否long pulse 訊號一定要拿來做同步處理?不做同步處理可以嗎?

如果不做同步處理?
任何的訊號,如果不做同步處理的話,都會有meta stable的產生的疑慮。而long pulse做同步
處理是比one-pulse訊號做同步處理來得容易多了。
很多人都認為long pulse不需要做同步處理,因為我下一個時間(next period time),就可
以得到正確的long pulse訊號。就對下一個時間點而言,這樣子的說法這是正確的,但是對
目前的時間點而言,你已經沒有辦法保證你所設計的系統是穩定的,除非,你設計一個
會mask meta stable訊號的設計,但是,這有可能嗎?同步處理是每一個 T (period time)都
在進行的,你要怎麼知道每一個小段時間的起始點? 任何訊號你想要得到之前,都是要同步過的。所以沒有辦法知道每一小段的起始點,因為連知道這個起始點的訊息,也是要同步的。

不做同步處理的原因有很多,總結上來說,是因為你的設計不管有沒有meta stable,都不
會影響系統的正確性,所以才會省略一個D-F.F.(D-Flip-Flop)。


如果做同步處理?
如果做同步處理, 則所有的訊號都會是收斂在同一個clock domain,提高系統穩定度。

做同步處理和不做同步處理,相差的D-F.F.只有幾個,並不會太多,就整個系統來說,也不會太多。就我的經驗,整個晶片裏,同步處理的D-F.F.並沒有佔到整個晶片的1%(甚至可能不到0.1%或是0.01%),為什麼要省這些D-F.F.,來讓系統有不穩定的機會。
降低成本的方式有很多,我們也可以用轉進更微小製程來降低成本,例如:90ns轉進到28ns製程。節省這個D-F.F,就節省面積來說,節省不到1%面積(甚至可能不到0.1%或是0.01%)的方式,換算成成本,應該會是多少錢呢?比起因系統不穩,而需付出NRE的費用來說,哪一個才是比較少的?

並不是說long-pulse 訊號在cross clock domain的處理上,一定要做同步;而是說,如果同步處理是你無法避免的過程,那麼省略這幾個D-F.F.的做法,能不做還是不做,因為它帶來的實際上的效益並沒有太大。對於有meta stable的訊號,標準流程應該是直接捨棄不用,而不用去考慮它是否會帶給系統不穩定的機會有多大。